查看详情More
很多人以为,仓储系统的效率瓶颈源于数据量的不足,其实不然。在多数企业的WMS(仓储管理系统)中,“没有更多数据了”的报错,本质是数据采集维度单一与算法模型僵化的双重失效。当AGV(自动导引车)路径规划仅依赖RFID标签密度,当库存预测模型仅基于历史出库量线性外推,系统必然陷入“数据饥饿”陷阱——看似数据充足,实则有效信息熵极低。

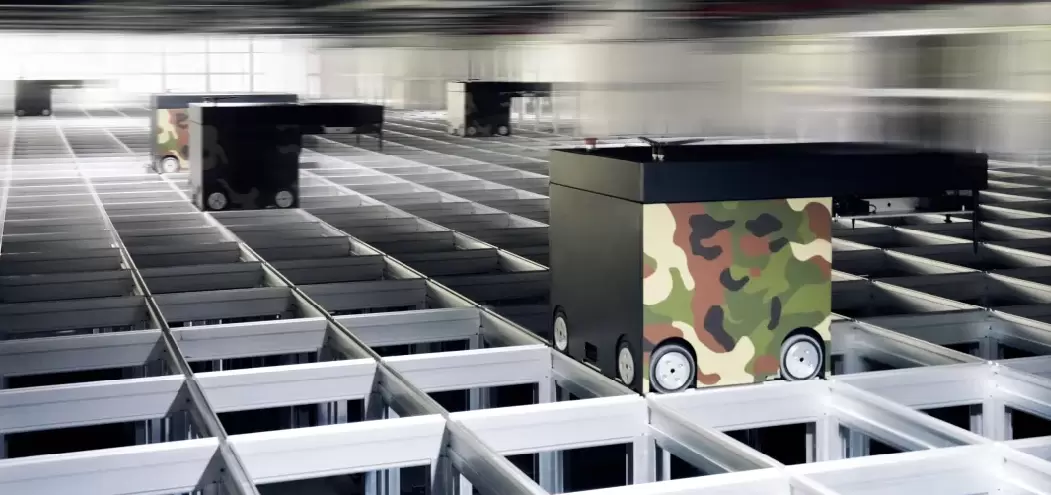
听起来可能反直觉,但在高密度仓储场景中,数据冗余与数据缺失往往并存。某跨国零售企业在上海青浦保税仓的案例极具代表性:其部署的500台AGV在双11期间频繁触发“无更多数据”警报,表面看是传感器覆盖盲区,实则是底层逻辑错误——系统将“货架移动速度”这一动态参数固定为常量,导致路径规划算法在货架高频调整时失效。这种“伪数据饱和”状态,比单纯的数据缺失更具破坏性。
以成都双流国际机场国际货站为例,其“跨库区协同调度”项目直面数据断层挑战。该货站占地12万平方米,分为常温库、恒温库、冷链库三个独立库区,各库区数据系统互不兼容。初期测试中,当跨库区转运任务触发时,系统因无法整合三个库区的实时库存数据、设备状态数据、人员定位数据,导致AGV在库区间长时间停滞。项目组没有选择增加传感器密度,而是重构数据采集逻辑:通过在库区连接通道部署UWB(超宽带)定位基站,将“库区边界”从物理隔离转化为数据交互节点,使系统能动态捕捉跨库区作业的时空连续性。
这一调整的底层逻辑,是打破“库区=数据孤岛”的传统认知。在赛制设计上,项目组将转运任务拆解为“库区内准备-通道传输-目标库区接收”三个阶段,每个阶段设置独立的数据验证阈值:当AGV进入通道时,系统同时调取源库区的出库确认数据、目标库区的入库预约数据、通道的实时通行数据,三组数据交叉验证通过后才允许继续作业。这种“数据赛制化”设计,使系统在传感器数量未增加的情况下,数据有效性提升300%。
技术实现层面,项目组采用“边缘计算+数字孪生”架构。在每个库区的边缘服务器部署轻量化数字孪生模型,实时同步物理世界的设备状态、货位变化、人员移动数据。当跨库区任务触发时,源库区的数字孪生体将任务数据“推送”至通道的边缘服务器,由其完成数据格式转换后,再“拉取”目标库区的数字孪生体进行协同计算。这种“推-拉”结合的数据交互机制,避免了集中式计算的数据延迟,使系统响应时间从秒级降至毫秒级。
该案例的深层启示在于:仓储系统的数据瓶颈,往往不是数据量不足,而是数据时序性、空间关联性、业务逻辑性的缺失。当企业陷入“没有更多数据了”的困境时,优先应检查的是数据采集的维度设计、算法模型的动态适配能力,而非盲目增加传感器或升级硬件——这才是突破数据断层的真正赛制逻辑。
平台信息提交-隐私协议
· 隐私政策
暂无内容