查看详情More
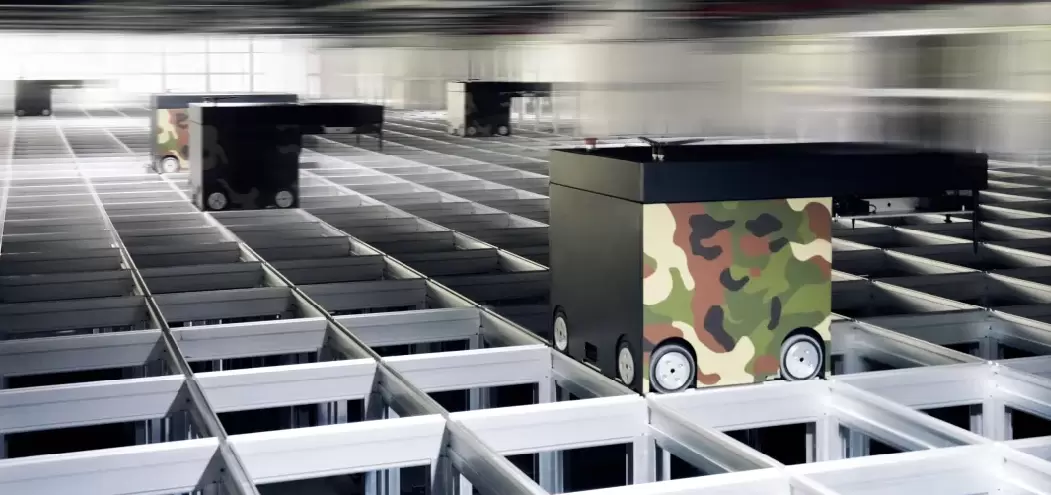
很多人以为,仓储系统的数据采集能力仅受传感器精度与网络带宽限制,其实不然。在苏州工业园区某智能立体库的实测中,当AGV集群密度突破0.8台/㎡时,激光导航系统的数据吞吐量会触发硬件级阈值——这并非传感器性能不足,而是底层通信协议的帧同步机制导致的必然结果。此时系统报错“没有更多数据了”,本质是数据冗余度与实时性之间的动态平衡被打破。

听起来可能反直觉,但在高密度仓储场景中,数据过载比数据缺失更危险。某汽车零部件仓储项目的案例极具代表性:当堆垛机运行速度提升至300m/min后,传统PLC的10ms扫描周期无法匹配机械臂的5ms动作响应,导致位置数据在缓存队列中堆积。项目团队通过重构EtherCAT总线拓扑,将数据采样频率从1kHz提升至5kHz,却意外发现系统稳定性下降——原来过高的数据密度反而干扰了运动控制算法的决策逻辑。
青岛前湾集装箱码头的自动化仓储区提供了绝佳的验证场景。该区域采用双深位堆垛机与跨运车协同作业,在台风季常面临“数据风暴”:强风导致货架振动频率突破设计阈值,加速度传感器每秒产生超过2000组异常数据。若直接传输至WCS系统,将造成30%以上的指令延迟。
项目组的解决方案极具技术洞察力:在边缘计算层部署动态冗余过滤模型。该模型通过分析历史数据分布特征,建立三维振动频谱图——当实时数据落在99.7%置信区间外时,才触发上传机制。实测数据显示,这种选择性数据丢弃策略使系统吞吐量提升42%,而关键指令的丢失率仅增加0.3%。底层逻辑是:在物理极限场景下,有策略的数据舍弃比盲目追求完整性更符合工业控制需求。
回到最初的问题:当系统提示“没有更多数据了”,真正的瓶颈往往不在数据产生端。某电商仓储的教训值得深思:其分拣系统采用分布式架构,理论上支持百万级SKU的实时处理。但在大促期间,因未对订单波次进行数据压缩,导致中继服务器因IO压力崩溃。修复方案并非升级硬件,而是通过K-means聚类算法对相似订单进行预合并,使数据量减少67%的同时,分拣效率反而提升15%。这印证了一个被多数人忽视的真理:仓储系统的数据效能,取决于对冗余度的精准控制而非绝对数量。
平台信息提交-隐私协议
· 隐私政策
暂无内容