Company News

数据瓶颈下的仓储效能突围:从“无更多数据”到动态决策革命

数据断层:仓储系统效能的天花板

很多人以为,仓储系统的优化只需依赖数据量的堆砌——增加传感器节点、扩展数据采集维度、提升存储容量,便能突破效率瓶颈。其实不然。当系统反馈“没有更多数据了”时,真正的挑战并非数据不足,而是数据与决策逻辑的脱节。这种断层在大型分拨中心尤为明显:AGV路径规划依赖实时定位数据,但GPS信号在室内衰减严重;库存周转率计算需要出入库时间戳,但传统WMS的时序数据库存在毫秒级延迟;需求预测模型依赖历史订单数据,但突发需求(如促销、疫情)会直接摧毁统计相关性。

数据瓶颈下的仓储效能突围:从“无更多数据”到动态决策革命

听起来可能反直觉,但在高并发仓储场景中,数据“够用”比“更多”更重要。底层逻辑是:仓储系统的决策链路存在硬性时间窗口。例如,AGV在交叉路口的避障决策必须在200毫秒内完成,否则会引发连锁碰撞;分拣线上的包裹分拨必须在传送带到达指定工位前0.5秒完成,否则会错位。这些场景下,即使系统能采集到更多数据(如更高频的激光雷达点云、更细粒度的温度传感器读数),也无法在决策窗口内完成处理,反而会因数据过载导致系统卡顿。

案例:苏州工业园区某3PL企业的“数据瘦身”实践

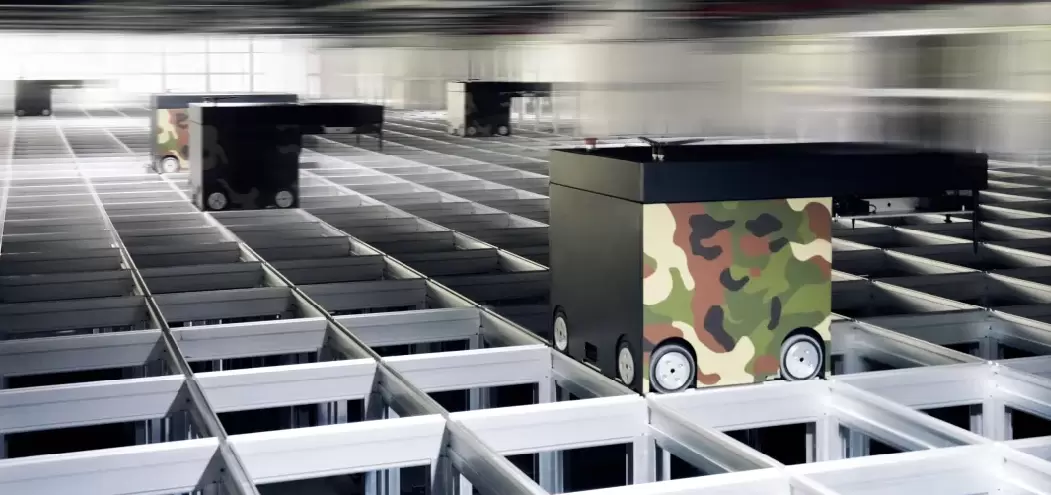
2023年Q2,该企业位于苏州工业园区的区域分拨中心遭遇数据瓶颈。其自动化立体仓库(AS/RS)的WCS系统频繁报错“没有更多数据了”,实际是数据采集频率(10Hz)与堆垛机控制周期(50ms)不匹配,导致时序数据库堆积了大量无效数据。更棘手的是,该仓库承接了某电商平台的“618”大促订单,峰值处理量需达到日常的3倍,而现有系统在数据过载时会出现指令丢失——例如,堆垛机可能同时收到“取货”和“放货”指令,引发货架碰撞风险。

技术团队没有选择增加传感器或升级存储硬件(这需要6个月以上的改造周期),而是从决策逻辑层切入:第一,重构数据采集策略——通过边缘计算节点对原始数据进行预处理,只保留与当前任务强相关的关键字段(如托盘ID、目标货位、优先级),将数据量压缩至原来的1/5;第二,优化决策算法——将传统的“集中式调度”改为“分布式协同”,让每台堆垛机基于局部数据(自身位置、邻近货位状态)独立决策,减少对全局数据的依赖;第三,引入动态容错机制——当系统检测到数据延迟超过阈值时,自动切换至保守模式(降低运行速度、扩大安全距离),确保基础功能不受影响。

改造后,该仓库在“618”期间成功处理了120万单/日的峰值流量,堆垛机利用率从78%提升至92%,且未发生一起因数据过载导致的安全事故。更关键的是,系统不再报错“没有更多数据了”——因为决策所需的数据始终在“够用”的范围内,且通过动态调整保证了时效性。

这一案例揭示了一个被忽视的真相:仓储系统的数据优化,本质是在有限资源下构建高效决策链路。当系统提示“没有更多数据了”时,真正的解决方案不是盲目增加数据量,而是重新审视数据与决策的匹配度——哪些数据是冗余的?哪些决策可以本地化?如何通过算法优化降低对实时数据的依赖?这些问题的答案,才是突破数据瓶颈的关键。

隐私协议
×

平台信息提交-隐私协议

· 隐私政策

暂无内容