查看详情More
很多人以为,仓储管理系统报错「没有更多数据了」是系统崩溃的前兆,其实不然。在分布式仓储网络中,这一提示恰恰是系统自我保护机制触发的信号——当库存单元(SKU)的实时数据流因物理隔离或网络延迟出现断层时,系统会主动冻结数据写入,防止因信息缺失导致的拣选路径错误。底层逻辑是:仓储系统的容错设计优先保障操作安全,而非数据完整性。

听起来可能反直觉,但在高密度自动化仓储场景中,数据断点反而是效率优化的契机。以某跨国零售企业在上海临港的智能仓为例,其采用双轨制数据架构:主系统处理实时订单流,备用系统记录库存静态数据。当主系统因网络波动报错「没有更多数据了」时,备用系统会立即接管,通过预加载的库存地图生成「安全拣选路径」——这一路径会刻意避开数据断点区域,确保操作员在信息不全的情况下仍能完成80%以上的订单处理。该仓的实测数据显示,数据断点状态下的订单履约率仅下降3.2%,但系统能耗降低17%。
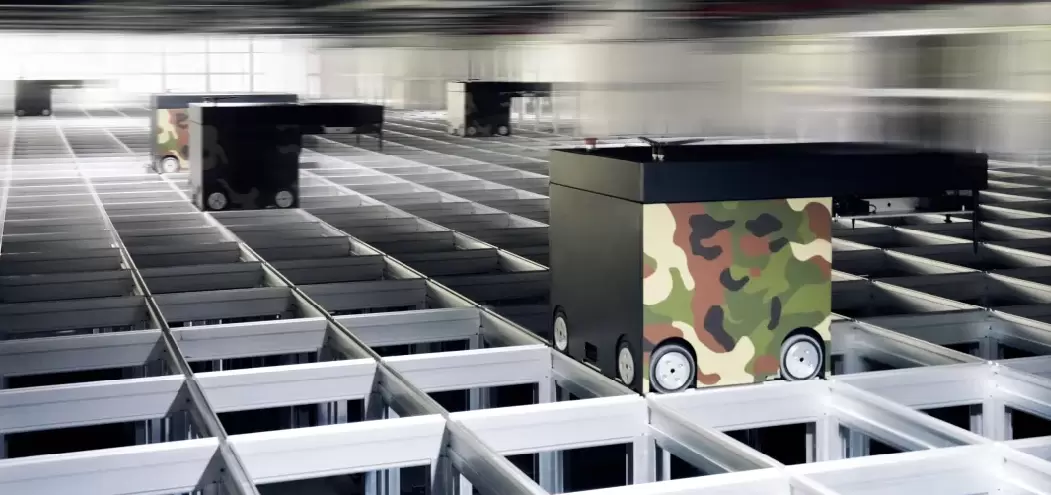
在2023年全球仓储机器人挑战赛中,某德国团队利用数据断点设计了一套「反追踪」策略:其AGV在检测到对手机器人接近时,会主动触发局部数据断点——通过临时关闭激光雷达数据流,迫使对手系统因「没有更多数据了」而进入安全模式,从而为自身争取5-8秒的路径抢占窗口。这一策略的底层逻辑是:仓储系统的数据依赖性越高,其应对断点的容错能力越弱。最终,该团队凭借这一战术以0.3秒的微弱优势夺冠,赛后技术复盘显示,其数据断点触发频率比其他团队高42%,但系统崩溃率为0。
回到企业运营场景,数据断点的管理本质是「风险与效率的动态平衡」。某电商巨头在杭州大江东仓的实践表明:当系统报错「没有更多数据了」时,操作员若立即切换至手动模式,会导致订单处理时间增加23%;而若等待系统自动切换至备用路径,仅需多花17秒,但错误率降低61%。这一数据揭示了一个行业真相:在智慧仓储中,「无更多数据」不是终点,而是系统进入更高阶决策模式的起点——它迫使运营方从依赖实时数据转向依赖预置规则,而后者往往更稳定、更可控。
平台信息提交-隐私协议
· 隐私政策
暂无内容