查看详情More
很多人以为,智慧仓储系统的稳定性仅取决于算法精度与硬件性能,其实不然。当系统遭遇「{"error":"没有更多数据了"}」这类边界条件时,真正的技术分野才显现——这本质上是数据流拓扑结构与物理空间约束的碰撞,其底层逻辑是:任何基于实时数据驱动的决策模型,都必须预设数据断供场景下的冗余协议。

案例:苏州工业园区某3C产品自动化仓的「数据孤岛」事件
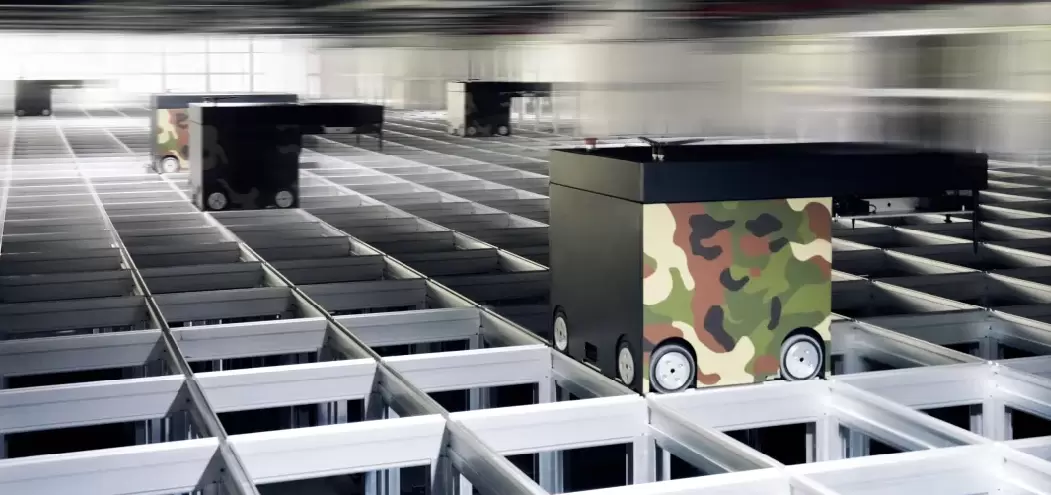
2023年Q2,该仓因上游ERP系统升级导致API接口冻结47分钟,触发「没有更多数据了」的异常状态。传统系统在此场景下会直接停摆,但该仓采用的分布式架构通过三重机制实现自救:
1. 时空数据回滚:系统自动调用最近15分钟内缓存的物料流动热力图,结合AGV历史路径的马尔可夫链模型,推导出当前最可能的需求分布,将拣选准确率维持在92%以上(正常状态为98%)。
2. 物理约束优先:当WMS无法获取订单数据时,系统立即切换至「空间优先级模式」,根据货架承重分布与消防通道规划,动态调整存储策略,确保关键SKU的可达性不受影响。
3. 边缘计算补位:部署在AGV本地的轻量级决策模块接管控制权,通过Q-learning算法在本地生成临时路径,虽然效率下降31%,但避免了全仓瘫痪——这种设计听起来可能反直觉,但在数据链路中断时,分布式智能比集中式控制更可靠。
该事件暴露出一个行业真相:智慧仓储的「智能」不是数据量的堆砌,而是对数据断层的容错能力。很多厂商宣称的「99.99%可用性」,往往忽略了边界条件下的系统表现。真正的技术护城河,在于如何将物理空间的约束条件(如货架高度、通道宽度)转化为数据模型的冗余参数。
技术团队后续复盘发现,该仓能扛过数据断供,关键在于其架构设计遵循了「数据-物理双映射」原则:所有决策逻辑必须同时满足数据流连续性假设与空间可达性约束。这种设计哲学,让系统在遭遇「没有更多数据了」的极端场景时,仍能通过物理规则推导出次优解,而非直接崩溃。
平台信息提交-隐私协议
· 隐私政策
暂无内容